Game Agent Coding League’in yeni kralı GPT-6.2-Astra
Uzun bir aradan sonra Game Agent Coding League’i güncellemeye karar verdim. Bilmeyenler için kısa bir özet: GACL'da dil modelleri oyunlar için bir agent kodu yazar. Daha sonra her modelin yazdığı agent kodlarıyla bir lig yapılır ve ortaya bir puan tablosu çıkar. Buradaki en önemli detay, dil modellerinin oyunu kendileri oynamadığı bilgisidir. Yani, oyunlar online olarak, her tur dil modeline sıradaki hamlenin sorulduğu şekilde yapılmaz. Agent kodları offline olarak oluşturulur ve o dakikadan sonra dil modelleriyle işimiz kalmamıştır. Agentlar aralarında yarışırlar.
21 Kasım’da en güçlü bulduğum 12 modelin yazdığı ajanları sekiz farklı oyunda yarıştırdım. Ajanlar 8 oyunda toplamda 200 binden fazla maç oynadı.
Google AI Ultra aboneliğim olmadığı için Gemini uygulamasında Carbon’u deneyemedim. Neon’u ise özellikle merak ediyordum. Artificial Analysis’in Intelligence Index’inde Neon (xhigh) 61, Carbon (high) 60 puan almıştı. Muse Wonder Full’a yalnızca Muse Code aboneleri erişebildiği için turnuvaya Muse Wonder’ı dahil ettim. Hangi 12 modelimi seçtiğimi buradan görebilirsin.
Modellere verdiğim promptları, agent'ları nereden oluşturduğumu, puanları nasıl hesapladığımı ve diğer ayrıntıları merak edersen ayrıntıları benchmark sayfasında bulabilirsin. Game Agent Coding League
GPT-6.2-Astra’nın tartışmasız liderliği
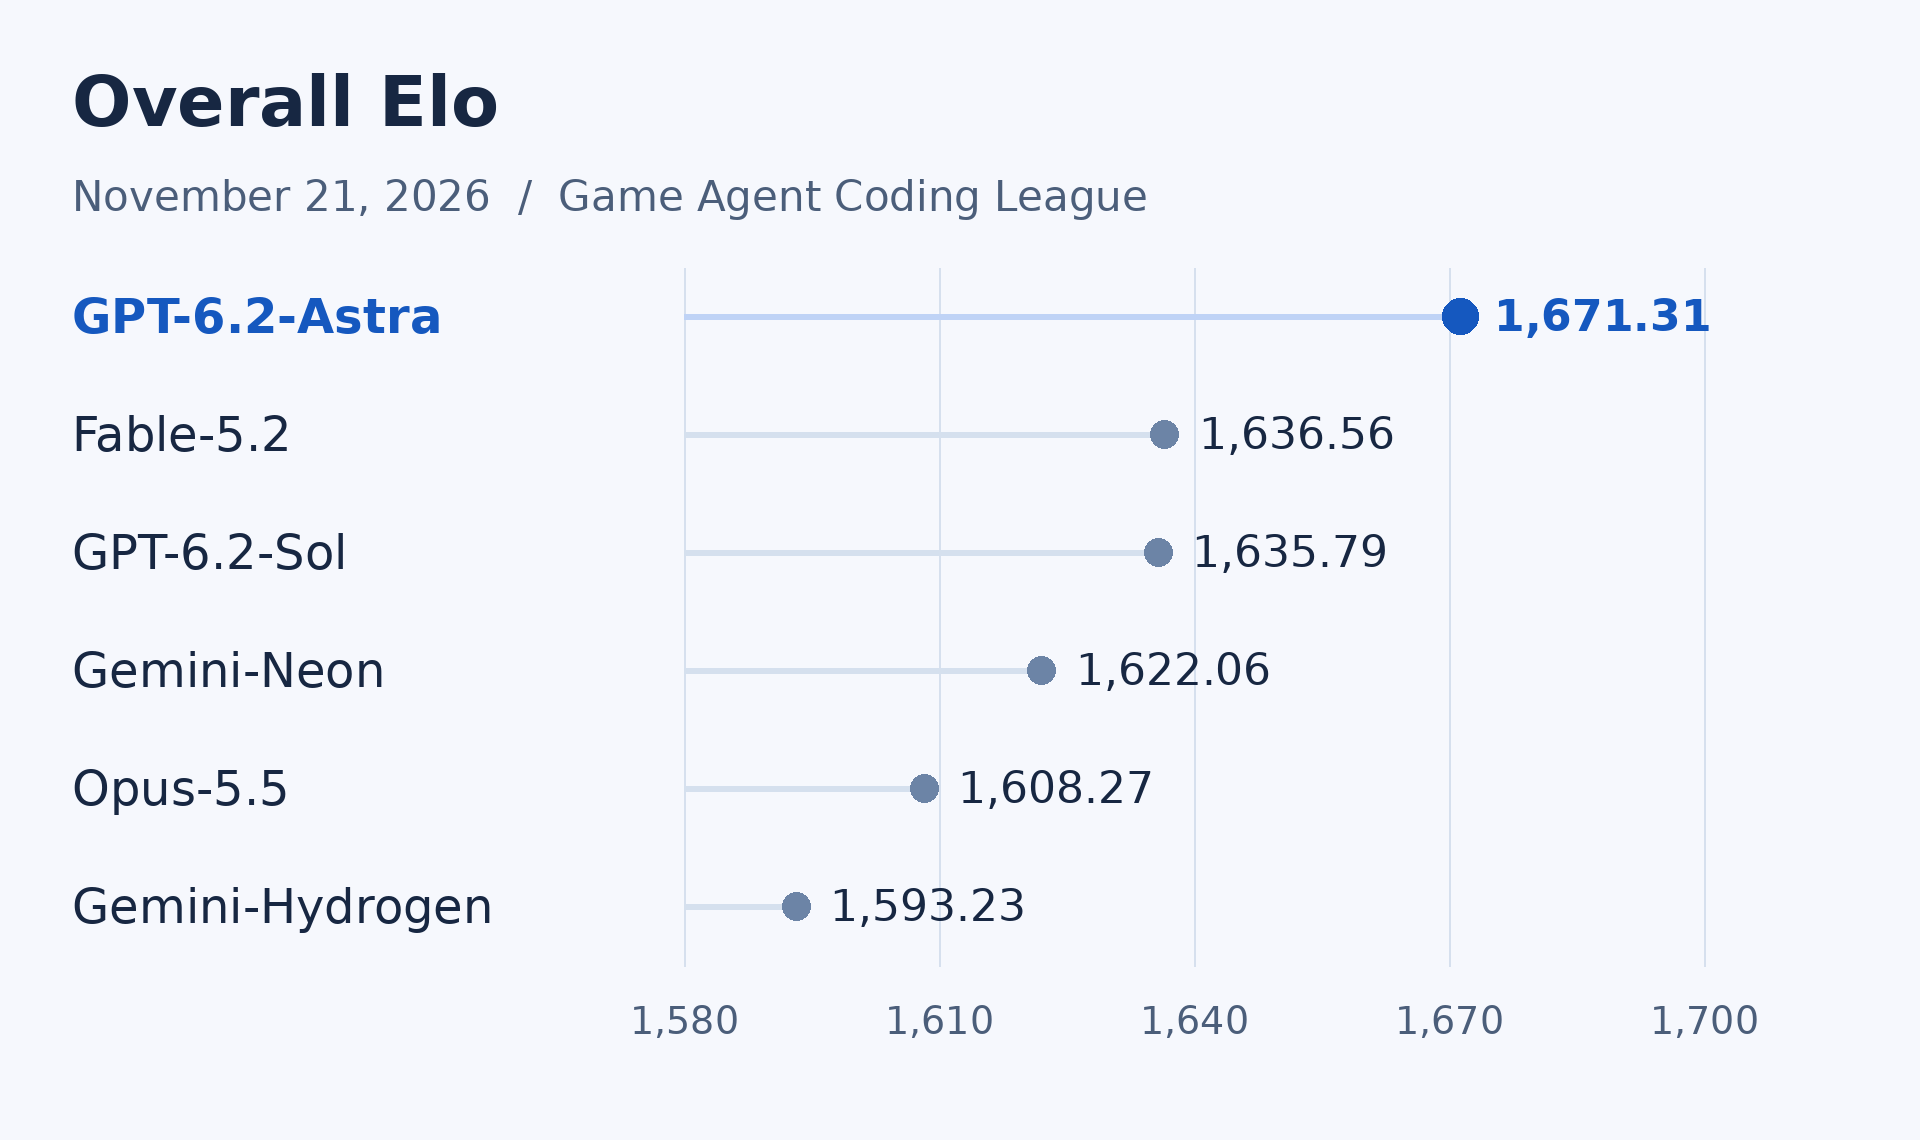
Astra dört kategorinin tümünde genel Elo sıralamasında da birinci oldu. Dört kategoriden kasıt ise şu: Sonuçlar 2 farklı filtre ile gözlemlenebiliyor. İlk filtre oyunların ağırlıkları eşit mi sayılsın yoksa farklı oyunların ağırlıkları farklı mı olsun? İkinci filtre ise her modelin sadece en iyi performans gösteren agent'ını mı kullanalım (Max Elo) yoksa bir modelin agent'larının ortalamasını mı alalım (Mean Elo)? Astra'nın 1.liği sürpriz değil ancak beni asıl şaşırtan, ikinciyle arasındaki farktı. Sekiz oyuna eşit ağırlık verip her modelin iki ajanının ortalama Elo puanını aldığımda Astra, ikinci sıradaki GPT-6.2-Sol’un 40,34 puan önünde bitirdi. Aynı sıralamada ikinciyle dördüncü arasında yalnızca 7,89 puan var. Gündelik kullanımda Astra ile Sol arasındaki farkı görmek zor olabiliyor. Burada ise aynı kurallarla oynayan ajanların sonuçlarını doğrudan karşılaştırabiliyorum.
Astra, Battleship, Connect4 ve WordMatrix sıralamalarını birinci bitirdi. Max Elo’da sekiz oyunun yedisinde ilk dörde girdi. Oyunlar arasında en çok Battleship sonucu dikkatimi çekti. Astra’nın en iyi ajanı 3.520 maçın 2.893’ünü kazandı (%82,2). Connect4’te ise Astra’nın iki ajanı ilk iki sırayı aldı. Sol’un ajanlarına karşı oynadıkları 64 maçın 45’ini kazandılar, üçünde berabere kaldılar. Turnuva sonuçları
Claude modelleri neden geride kaldı?
İnternetteki testlerin büyük çoğunluğunda, özellikle de YouTube’daki görsel odaklı ve ucu açık komutlar içeren ("bana şunu üret", "şehir tasarla", "oyun yap" gibi) kıyaslamalarda beklenti tam olarak tanımlanmamıştır ve kullanıcıyı tatmin etmenin binlerce farklı yolu vardır. Bana göre Claude modellerinin asıl fark yarattığı nokta da tam olarak burası. Çıktının net çizgilerle belirlenmediği senaryolarda Claude; ince detaylara odaklanıp daha fazla zaman ve token harcayarak ortaya çıkan işin kalitesini bambaşka bir seviyeye taşıyor.
GPT modelleri ise bu tarz belirsiz komutlarla karşılaştığında Claude’a kıyasla neredeyse yarı yarıya daha az token tüketiyor ve kullanıcının eksik bıraktığı yerleri kendi inisiyatifiyle tamamlamaya çalışmıyor; yalnızca isteneni, ayrıntılara boğulmadan üretip geçiyor. Bu durum bana birkaç hafta önce okuduğum ama kaynağını şu an hatırlayamadığım bir yazıyı anımsattı: Yıllarını yazılıma vermiş deneyimli geliştiriciler, talep etmedikleri ekstra işler yapılmasını istemedikleri için GPT’yi Claude’a tercih ediyor. Öte yandan yazılım geçmişi olmayan ya da bu alanda yeni olup yapay zekâ desteğiyle bir şeyler ortaya çıkarmaya çalışan kitle ise, komutlardaki boşlukları etkileyici bir şekilde doldurup kendilerini şaşırttığı için Claude’a yöneliyor.
Peki bunun mevcut kıyaslamayla ilgisi ne? Şöyle ki: Burada alışılagelmiş anlamda yaratıcılık sergilemek pek mümkün değil. GACL'da yaratıcılık, istenmeyen detaylara odaklanmak yerine daha zeki bir ajan inşa etmek anlamına geliyor. Yani bu testte —oyunlardaki süre kısıtlaması nedeniyle kötü optimize edilmiş kodların iyi hamle yapmayı zorlaştıracağını da hesaba katarsak, biraz kodlama becerisiyle birlikte— doğrudan saf zekâ ölçülüyor.
Sözü fazla uzattım, kısaca toparlamak gerekirse: "Sadece dediğimi yapsın, başka hiçbir şeye karışıp boşluklarımı doldurmasın" diyorsanız Claude modellerinden uzak durun. Ancak "Komutlarım yüzeysel kalıyor, yazdıklarıma pek güvenmiyorum ve sonucun beni etkilemesini istiyorum" diyorsanız, Claude ile yola devam edebilirsiniz.
Gemini geri döndü!
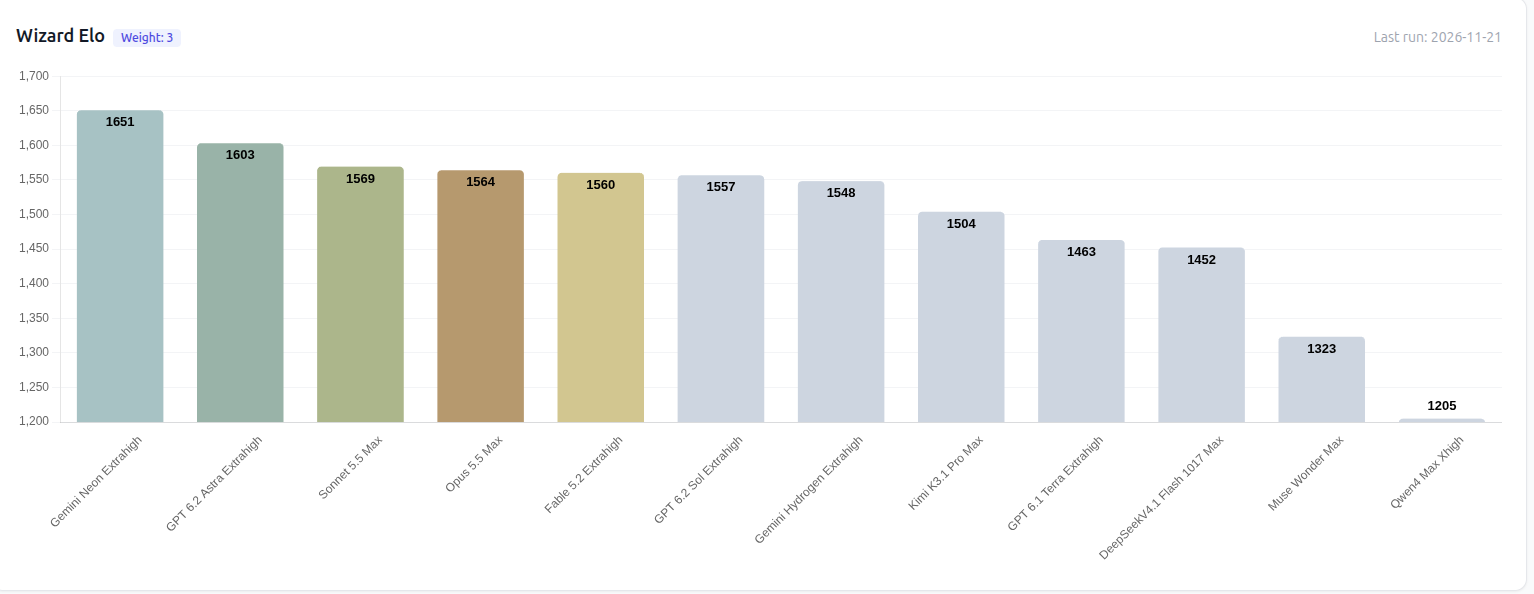
Yeni Gemini modelleri çıktığında forumlarda ve YouTube’da haklarında epey övgü duymuştum. Neon’un özellikle Wizard’daki sonucuna sevindim. Altı kişilik oyunda Astra’yı geçip birinci oldu. Eşit ağırlıklı Max Elo sıralamasında da Sol ile Opus arasına yerleşti. Hydrogen ise Sonnet’i açık farkla geçerek altıncı oldu.
Peki Sonnet’i kim kullanıyor?
Haiku’yu fiyatına göre başarılı buluyorum, gerçi bu turda onu yarıştırmadım. Bir yanda Haiku, diğer yanda Opus ve Fable varken Sonnet’i hangi işlerde tercih edeceğimi ben de merak ediyordum. Sonnet 5.5 açık ağırlıklı modellerin hepsini geçti, Hydrogen’in hemen arkasında kaldı. Benim dikkatimi Sol ile arasındaki fark çekti. Sol bu oyunlarda daha başarılı ajanlar yazdı ve iki modelin standart API fiyatı aynı. Her ikisinde de bir milyon girdi tokenı 2 dolar, bir milyon çıktı tokenı 10 dolar. Anthropic fiyatı · OpenAI fiyatı
Açık ağırlıklı modeller arasında DeepSeek öne çıktı
DeepSeek-V4.1-Flash-1017 sekizinci oldu. Sonnet’le arasında yalnızca 11,39 Elo puanı var. Kimi K3.1 Pro’yu ise 45,58 puanla geçti. Açık ağırlıklı bir modelin bu turda Sonnet’e bu kadar yaklaşmasını beklemiyordum.
Açık ağırlıklı modellerin ajanlarını DeepSeek Harness ile ürettim. Bu, DeepSeek’in kendi modeline avantaj sağlamış olabilir. Ben bu etkinin küçük kaldığını düşünüyorum. Ajanların nasıl üretildiği
GPT-6.1-Terra, görsel işlere devam
Terra, 12 model arasında 11. oldu. DeepSeek ve Kimi’nin gerisinde kaldı, kapalı ağırlıklı Qwen4-Max’i ise geçti. Terra’yı görsel anotasyon ve OCR gibi görsel işlerde kullanmaya devam edeceğim. Başka işlerde ona pek başvurmayacağım.
Senin dikkatini en çok hangi sonuç çekti? Sonuçları konuşmak istersen ya da gözümden kaçan bir hata görürsen bana yazabilirsin. Görüşmek üzere!