GPT-6.2-Astra ist der neue König der Game Agent Coding League
Nach einer längeren Pause habe ich beschlossen, die Game Agent Coding League zu aktualisieren. Wenn du die GACL noch nicht kennst, hier ein kurzer Überblick. Sprachmodelle schreiben den Code für Agenten, die bestimmte Spiele spielen können. Die Agenten treten in einer Liga gegeneinander an, und aus ihren Ergebnissen entsteht eine Rangliste. Entscheidend ist, dass die Agenten jeden Zug selbst bestimmen. Ihr Code wird vorab offline erzeugt. Danach spielen die Agenten eigenständig gegeneinander, ohne dass in jeder Runde ein Sprachmodell nach dem nächsten Zug gefragt wird.
Am 21. November habe ich die Agenten der zwölf Modelle, die ich für die stärksten hielt, in acht verschiedenen Spielen gegeneinander antreten lassen. Insgesamt spielten die Agenten über 200.000 Partien.
Da ich kein Google-AI-Ultra-Abo habe, konnte ich Carbon in der Gemini-App nicht ausprobieren. Auf Neon war ich besonders gespannt. Im Intelligence Index von Artificial Analysis kam Neon (xhigh) auf 61 Punkte und Carbon (high) auf 60. Ich habe Muse Wonder ins Turnier aufgenommen, weil nur Abonnenten von Muse Code Zugriff auf Muse Wonder Full haben. Hier findest du die zwölf Modelle, die ich ausgewählt habe.
Auf der Benchmark-Website findest du die Prompts, die ich den Modellen gegeben habe. Dort steht auch, wo ich die Agenten erzeugt habe, wie ich die Punkte berechnet habe und was es sonst noch über den Benchmark zu wissen gibt. Game Agent Coding League
GPT-6.2-Astras unangefochtene Führung
Astra belegte in allen vier Elo-Gesamtwertungen den ersten Platz. Die vier Wertungen ergeben sich aus der Kombination zweier Filter. Mit dem ersten lässt sich einstellen, ob alle Spiele gleich oder unterschiedlich gewichtet werden. Beim zweiten kann man pro Spiel den besten Agenten jedes Modells heranziehen (Max Elo) oder die Elo-Werte seiner Agenten mitteln (Mean Elo). Mit Astras Sieg hatte ich gerechnet. Überrascht hat mich der Abstand zum Zweitplatzierten. Wenn ich alle acht Spiele gleich gewichte und den Elo-Durchschnitt der beiden Agenten pro Modell bilde, liegt Astra 40,34 Punkte vor GPT-6.2-Sol auf Platz zwei. Zwischen Platz zwei und Platz vier liegen in derselben Wertung gerade einmal 7,89 Punkte. Im Alltag ist der Unterschied zwischen Astra und Sol manchmal schwer zu erkennen. Hier kann ich die Ergebnisse von Agenten direkt vergleichen, die nach denselben Regeln spielen.
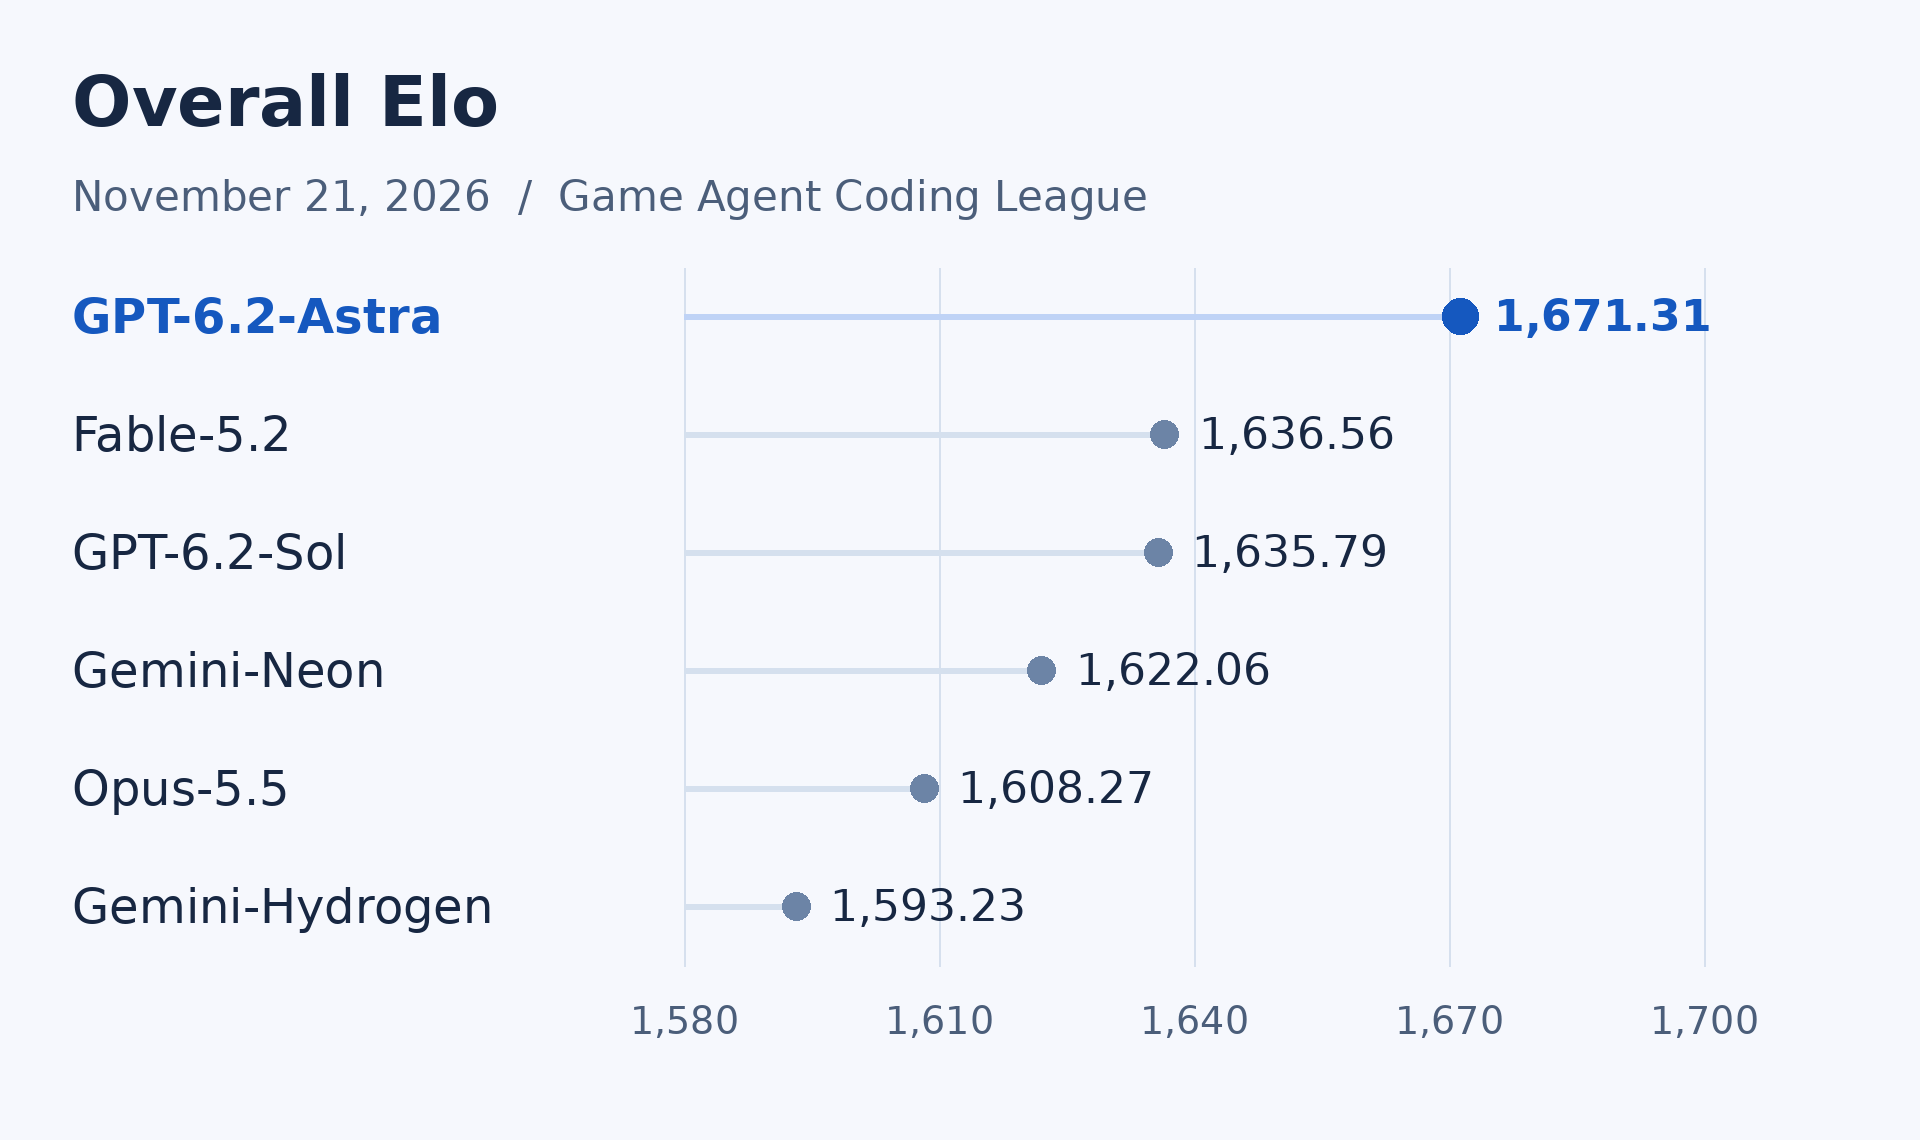
Astra belegte in Battleship, Connect4 und WordMatrix den ersten Platz. Nach Max Elo kam Astra in sieben der acht Spiele unter die ersten vier. Das Ergebnis in Battleship ist mir besonders aufgefallen. Astras bester Agent gewann 2.893 von 3.520 Partien (82,2 %). In Connect4 belegten die beiden Agenten von Astra die ersten beiden Plätze. Gegen Sols Agenten gewannen sie 45 von 64 Partien, drei endeten unentschieden. Turnierergebnisse
Warum blieben die Claude-Modelle zurück?
Bei den meisten Tests im Netz ist nur grob vorgegeben, was am Ende herauskommen soll. Das gilt besonders für YouTube-Vergleiche, bei denen es vor allem um die Optik geht und die Prompts bewusst offen sind, etwa „Mach mir das hier“, „Entwirf eine Stadt“ oder „Bau ein Spiel“. Es gibt Tausende Wege, den Nutzer zufriedenzustellen. Genau da machen die Claude-Modelle für mich den Unterschied. Wenn das Ergebnis nur grob umrissen ist, achtet Claude auf Feinheiten, investiert mehr Zeit und Token und hebt die Qualität des Ergebnisses auf ein ganz anderes Niveau.
Bei solchen vagen Prompts brauchen GPT-Modelle im Vergleich zu Claude ungefähr halb so viele Token und lassen die Lücken in den Vorgaben offen. Sie liefern, was verlangt wurde, ohne sich in Details zu verlieren. Das erinnert mich an einen Artikel, den ich vor ein paar Wochen gelesen habe und dessen Quelle mir gerade nicht einfällt. Wer seit Jahren Software entwickelt, bevorzugt demnach GPT, weil es sich an den Auftrag hält. Menschen mit wenig oder keiner Erfahrung in der Softwareentwicklung, die mit KI etwas auf die Beine stellen wollen, greifen eher zu Claude. Es ergänzt fehlende Vorgaben auf beeindruckende Weise und überrascht sie mit dem Ergebnis.
Was hat das mit diesem Benchmark zu tun? Für Kreativität im üblichen Sinn gibt es hier wenig Spielraum. Kreativität steckt in der GACL darin, im Rahmen der Aufgabe einen clevereren Agenten zu bauen. Der Benchmark misst direkt reine Intelligenz und ein wenig Programmierfähigkeit. Wegen der Zeitlimits in den Spielen kann schlecht optimierter Code es einem Agenten erschweren, einen guten Zug zu finden.
Ich habe schon zu weit ausgeholt. Wenn das Modell genau tun soll, was du ihm sagst, und alles andere offenlassen soll, mach einen Bogen um die Claude-Modelle. Wenn deine Prompts eher oberflächlich bleiben, du deinen eigenen Vorgaben nicht ganz traust und dich das Ergebnis beeindrucken soll, kannst du bei Claude bleiben.
Gemini meldet sich zurück
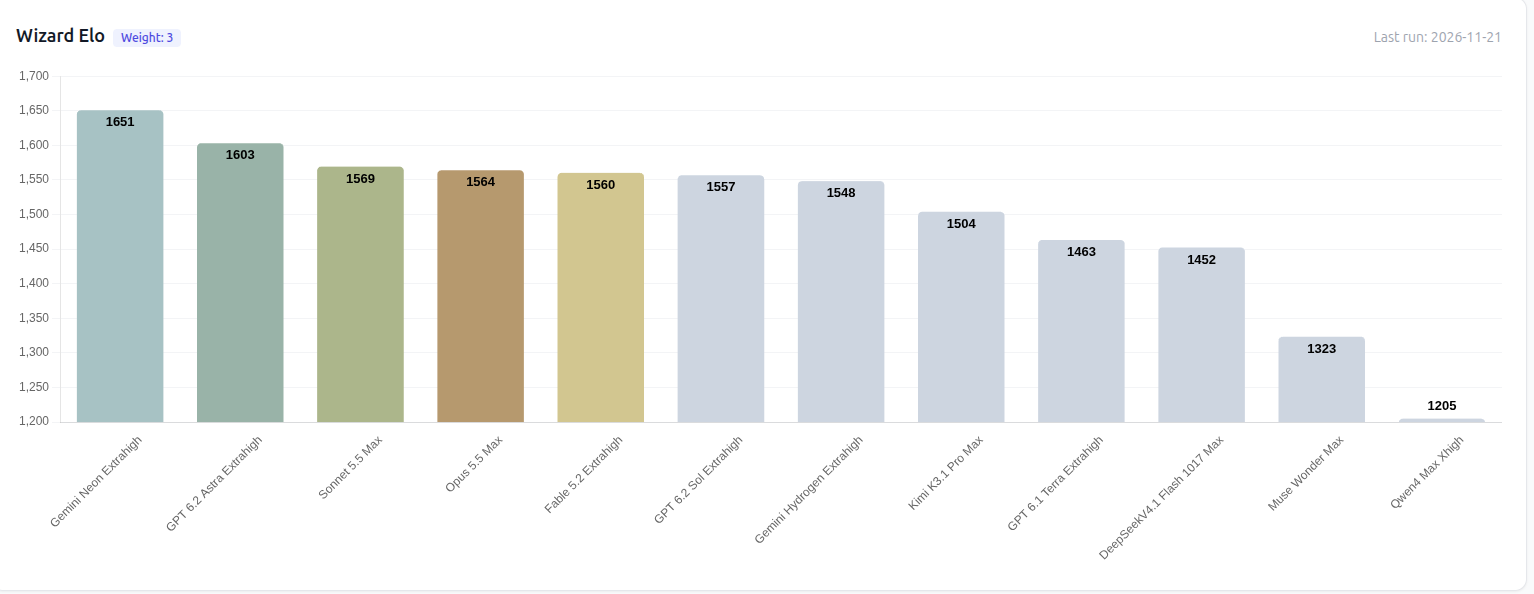
Als die neuen Gemini-Modelle erschienen, habe ich in Foren und auf YouTube viel Lob für sie gehört. Besonders gefreut hat mich Neons Ergebnis in Wizard. In der Variante mit sechs Spielern schlug Neon Astra und wurde Erster. Bei gleicher Spielgewichtung landete Neon nach Max Elo zwischen Sol und Opus. Hydrogen belegte mit deutlichem Vorsprung auf Sonnet den sechsten Platz.
Wer nutzt eigentlich Sonnet?
Für seinen Preis finde ich Haiku ziemlich gut, auch wenn ich es diesmal nicht antreten ließ. Mit Haiku auf der einen Seite und Opus und Fable auf der anderen habe ich mich gefragt, für welche Aufgaben ich Sonnet wählen würde. Sonnet 5.5 schlug alle Modelle mit offenen Gewichten und landete knapp hinter Hydrogen. Aufgefallen ist mir der Abstand zu Sol. Sol schrieb für diese Spiele bessere Agenten, und beide Modelle haben denselben Standardpreis in der API. Beide kosten 2 Dollar pro Million Eingabetoken und 10 Dollar pro Million Ausgabetoken. Preise von Anthropic · Preise von OpenAI
DeepSeek sticht unter den Modellen mit offenen Gewichten heraus
DeepSeek-V4.1-Flash-1017 wurde Achter. Der Abstand zu Sonnet betrug nur 11,39 Elo-Punkte. Vor Kimi K3.1 Pro lag DeepSeek mit 45,58 Punkten Vorsprung. Ich hatte nicht erwartet, dass ein Modell mit offenen Gewichten in dieser Runde so nah an Sonnet herankommt.
Für die Modelle mit offenen Gewichten habe ich die Agenten mit dem DeepSeek Harness erzeugt. Das könnte DeepSeeks eigenem Modell einen Vorteil verschafft haben. Ich vermute, dass dieser Effekt klein war. Wie die Agenten entstanden sind
GPT-6.1-Terra, bleib bei den Bildern
Terra landete auf Platz elf von zwölf, hinter DeepSeek und Kimi und vor Qwen4-Max, einem Modell mit geschlossenen Gewichten. Für visuelle Aufgaben wie Bildannotation und OCR werde ich Terra weiter einsetzen. Bei anderen Aufgaben werde ich nur selten darauf zurückgreifen.
Welches Ergebnis ist dir am meisten aufgefallen? Wenn du über die Ergebnisse sprechen möchtest oder einen Fehler entdeckst, den ich übersehen habe, schreib mir gern. Bis zum nächsten Mal!